दिन 34: Window Functions और CTEs
✅ आज आप सीखेंगे
- CTEs: पढ़ने में आसान multi-step queries
- Window functions vs GROUP BY
- ROW_NUMBER, RANK, DENSE_RANK और हर group के top-N
- Running totals और moving averages
- LAG/LEAD growth और NTILE segments
🏢 असली दुनिया में
“हर शहर के top 2 products”, “month-over-month growth”, “सालाना target की ओर cumulative revenue”, “हर department के अंदर salary rank” – ये चार सवाल लगभग हर data-analyst SQL round में आते हैं, और चारों के लिए window functions चाहिए।
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
pd.read_csv("sales_data.csv").to_sql("sales", con, if_exists="replace", index=False)
pd.read_csv("employees.csv").to_sql("employees", con, if_exists="replace", index=False)
pd.read_csv("departments.csv").to_sql("departments", con, if_exists="replace", index=False)
print([r[0] for r in con.execute("SELECT name FROM sqlite_master WHERE type = 'table'")])CTEs – WITH
CTE एक sub-query को नाम देता है ताकि query steps में बना सकें – Python के variables जैसा।
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH orders AS (
    SELECT order_id, city, category, order_date,
           quantity * unit_price * (1 - discount) AS revenue
    FROM sales
),
city_rev AS (
    SELECT city, SUM(revenue) AS revenue FROM orders GROUP BY city
)
SELECT city, ROUND(revenue / 100000.0, 2) AS revenue_lakh
FROM city_rev
WHERE revenue > (SELECT AVG(revenue) FROM city_rev)      -- alias usable now!
ORDER BY revenue DESC
"""))Window functions: rows बनाए रखें
GROUP BY
- Rows समेटता है: हर group की एक row
- हर department का SUM(salary)
- pandas agg जैसा
Window: OVER (PARTITION BY …)
- हर row रखता है और group value जोड़ता है
- हर employee + department total
- pandas transform / rank / shift जैसा
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
SELECT name, dept_id, salary,
       ROUND(AVG(salary) OVER (PARTITION BY dept_id))            AS dept_avg,
       salary - ROUND(AVG(salary) OVER (PARTITION BY dept_id))   AS vs_avg,
       ROUND(100.0 * salary / SUM(salary) OVER (PARTITION BY dept_id), 1) AS share_pct
FROM employees
WHERE dept_id IN (10, 30)
ORDER BY dept_id, salary DESC
"""))Ranking functions
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH team(name, salary) AS (
    VALUES ('Aman', 90000), ('Riya', 90000), ('Om', 85000),
           ('Zoya', 80000), ('Kabir', 80000), ('Isha', 75000)
)
SELECT name, salary,
       ROW_NUMBER() OVER (ORDER BY salary DESC) AS row_num,
       RANK()       OVER (ORDER BY salary DESC) AS rnk,
       DENSE_RANK() OVER (ORDER BY salary DESC) AS dense_rnk
FROM team
"""))बराबर salaries पर ROW_NUMBER फिर भी 1, 2, 3 देता है; RANK 1, 1, 3 (छोड़ता है); DENSE_RANK 1, 1, 2 (कोई gap नहीं)। Interviewers दूसरी सबसे बड़ी salary पूछना पसंद करते हैं – DENSE_RANK लें।
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH r AS (
    SELECT city, product, ROUND(SUM(quantity * unit_price * (1 - discount))) AS revenue,
           ROW_NUMBER() OVER (PARTITION BY city ORDER BY SUM(quantity * unit_price * (1 - discount)) DESC) AS rn
    FROM sales
    GROUP BY city, product
)
SELECT city, product, revenue FROM r WHERE rn <= 2 AND city IN ('Delhi', 'Mumbai', 'Patna', 'Jaipur')
ORDER BY city, rn
"""))import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH ranked AS (
SELECT d.dept_name, e.name, e.salary,
DENSE_RANK() OVER (PARTITION BY e.dept_id ORDER BY e.salary DESC) AS r
FROM employees e JOIN departments d ON e.dept_id = d.dept_id
)
SELECT dept_name, name, salary FROM ranked WHERE r = 2 -- 2nd highest per department
"""))Running totals और moving averages
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
m = q("""
WITH monthly AS (
    SELECT strftime('%Y-%m', order_date) AS month,
           SUM(quantity * unit_price * (1 - discount)) / 100000.0 AS rev
    FROM sales GROUP BY month
)
SELECT month, ROUND(rev, 2) AS revenue_lakh,
       ROUND(SUM(rev) OVER (ORDER BY month), 2)                                   AS cumulative,
       ROUND(AVG(rev) OVER (ORDER BY month ROWS BETWEEN 2 PRECEDING AND CURRENT ROW), 2) AS moving_avg_3m
FROM monthly
""")
print(m.to_string(index=False))import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
import matplotlib.pyplot as plt
m = q("""
WITH monthly AS (SELECT strftime('%m', order_date) AS month, SUM(quantity * unit_price * (1 - discount)) / 100000.0 AS rev
FROM sales GROUP BY month)
SELECT month, rev, SUM(rev) OVER (ORDER BY month) AS cum FROM monthly
""")
fig, ax = plt.subplots(figsize=(9, 3.8))
ax.bar(m["month"], m["rev"], color="#c7d2fe", label="monthly")
ax.plot(m["month"], m["cum"], color="#4f46e5", marker="o", label="cumulative")
ax.axhline(65, color="#dc2626", ls="--", label="annual target ₹65 lakh")
cross = m.loc[m["cum"] >= 65, "month"].iloc[0]
ax.set_title(f"Annual target crossed in month {cross}"); ax.set_ylabel("₹ lakh"); ax.legend()
plt.show()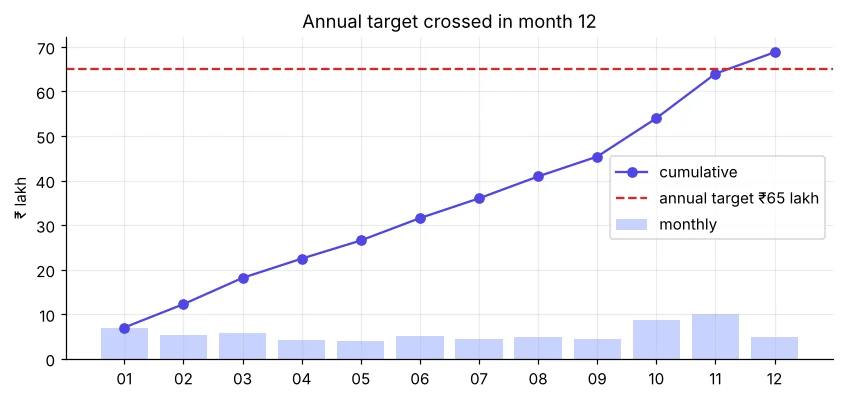
LAG और LEAD: growth
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH monthly AS (
    SELECT strftime('%Y-%m', order_date) AS month,
           SUM(quantity * unit_price * (1 - discount)) AS rev
    FROM sales GROUP BY month
)
SELECT month,
       ROUND(rev / 1e5, 2)                               AS rev_lakh,
       ROUND(LAG(rev) OVER (ORDER BY month) / 1e5, 2)    AS prev_lakh,
       ROUND(100.0 * (rev - LAG(rev) OVER (ORDER BY month)) / LAG(rev) OVER (ORDER BY month), 1) AS mom_growth_pct
FROM monthly
""").to_string(index=False))NTILE: segments
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""
WITH c AS (
    SELECT city, SUM(quantity * unit_price * (1 - discount)) AS rev FROM sales GROUP BY city
)
SELECT city, ROUND(rev) AS revenue,
       NTILE(3) OVER (ORDER BY rev DESC) AS tier,
       ROUND(PERCENT_RANK() OVER (ORDER BY rev), 2) AS pct_rank
FROM c ORDER BY rev DESC
"""))| SQL window | pandas |
|---|---|
| AVG(x) OVER (PARTITION BY g) | df.groupby("g")["x"].transform("mean") |
| ROW_NUMBER() OVER (PARTITION BY g ORDER BY x DESC) | df.groupby("g")["x"].rank(method="first", ascending=False) |
| SUM(x) OVER (ORDER BY t) | df["x"].cumsum() |
| AVG(x) OVER (… ROWS 2 PRECEDING) | df["x"].rolling(3).mean() |
| LAG(x) | df["x"].shift(1) |
| NTILE(4) | pd.qcut(df.x, 4) |
🏅 आज के Job Skills
Practice tasks
🏋️ Practice – ख़ुद करें
Solution देखें
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""WITH c AS (SELECT region, city, SUM(quantity*unit_price*(1-discount)) AS rev FROM sales GROUP BY region, city)
SELECT region, city, ROUND(rev) AS rev, RANK() OVER (PARTITION BY region ORDER BY rev DESC) AS rnk FROM c ORDER BY region, rnk"""))Solution देखें
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""SELECT DISTINCT salary FROM (SELECT salary, DENSE_RANK() OVER (ORDER BY salary DESC) AS r FROM employees) WHERE r = 3"""))Solution देखें
import sqlite3
import pandas as pd
con = sqlite3.connect("bazaar.db")
q = lambda sql: pd.read_sql(sql, con)
print(q("""WITH w AS (SELECT strftime('%W', order_date) AS week, COUNT(*) AS orders FROM sales
WHERE order_date BETWEEN '2024-10-01' AND '2024-10-31' GROUP BY week)
SELECT week, orders, SUM(orders) OVER (ORDER BY week) AS running FROM w"""))Quick quiz
🧠 Quick Quiz – ख़ुद को जाँचें
Interview corner
💼 Interview Corner
हर category के revenue के हिसाब से top 3 products की query लिखिए।
WITH r AS (SELECT category, product, SUM(rev) AS rev, ROW_NUMBER() OVER (PARTITION BY category ORDER BY SUM(rev) DESC) AS rn FROM sales GROUP BY category, product) SELECT * FROM r WHERE rn <= 3;
SQL में month-over-month growth कैसे निकालेंगे?
CTE में हर महीने की एक row बनाएँ, फिर (rev − LAG(rev) OVER (ORDER BY month)) / LAG(rev) OVER (ORDER BY month) × 100।
सारांश
- WITH … AS पढ़ने में आसान step-by-step queries बनाता है।
- OVER (PARTITION BY … ORDER BY …) rows समेटे बिना group values जोड़ता है।
- Rankings और top-N के लिए ROW_NUMBER/RANK/DENSE_RANK।
- Running totals के लिए SUM OVER, growth के लिए LAG, tiers के लिए NTILE।
Day 35: SQL + pandas project – छोटा sales database बनाकर 8 business सवालों के पूरे जवाब दें।
