दिन 41: Confusion Matrix, Precision, Recall, ROC
✅ आज आप सीखेंगे
- Confusion matrix: TP, FP, FN, TN
- Imbalanced data पर accuracy paradox
- Precision, recall और F1 – कब कौन ज़रूरी
- ROC-AUC और precision-recall curves
- Business cost न्यूनतम करने वाला threshold चुनना
🏢 असली दुनिया में
100 में सिर्फ़ 2 UPI transactions fraud हैं। “कभी fraud नहीं” कहने वाला model 98% accurate है – और बिल्कुल बेकार। Payments team को जानना है: frauds में से कितने पकड़ते हैं? हमारे alerts में कितने असली हैं? आज आप दोनों का जवाब देना सीखेंगे।
import numpy as np
import pandas as pd
from sklearn.datasets import make_classification
X, y = make_classification(n_samples=20000, n_features=8, n_informative=5, weights=[0.98], class_sep=1.2, random_state=7)
cols = ["amount_z", "hour_z", "device_age", "geo_dist", "merchant_risk", "txn_last_hr", "card_age", "velocity"]
pd.DataFrame(X, columns=cols).assign(is_fraud=y).to_csv("upi_transactions.csv", index=False)
print("Saved upi_transactions.csv | fraud rate:", round(y.mean() * 100, 2), "%")Confusion matrix
| Predicted fraud | Predicted normal | |
|---|---|---|
| असल में fraud | TP – पकड़ा ✅ | FN – चूका 💸 |
| असल में normal | FP – झूठा alarm 😠 | TN – सही छोड़ा ✅ |
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.dummy import DummyClassifier
from sklearn.metrics import confusion_matrix, accuracy_score
df = pd.read_csv("upi_transactions.csv")
X, y = df.drop(columns="is_fraud"), df["is_fraud"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
dummy = DummyClassifier(strategy="most_frequent").fit(X_tr, y_tr)
model = LogisticRegression(max_iter=2000).fit(X_tr, y_tr)
for name, m in [("always 'normal'", dummy), ("logistic regression", model)]:
    p = m.predict(X_te)
    tn, fp, fn, tp = confusion_matrix(y_te, p).ravel()
print(f"{name:20s} accuracy={accuracy_score(y_te, p):.3f} TP={tp} FN={fn} FP={fp} TN={tn}")दोनों models की accuracy ~98% है, फिर भी dummy एक भी fraud नहीं पकड़ता। Imbalanced data पर accuracy ज़रूरी सब कुछ छिपा देती है।
Precision, recall, F1
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, ConfusionMatrixDisplay
import matplotlib.pyplot as plt
df = pd.read_csv("upi_transactions.csv")
X, y = df.drop(columns="is_fraud"), df["is_fraud"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
m = LogisticRegression(max_iter=2000).fit(X_tr, y_tr)
print(classification_report(y_te, m.predict(X_te), target_names=["normal", "fraud"], digits=3))
ConfusionMatrixDisplay.from_estimator(m, X_te, y_te, display_labels=["normal", "fraud"], cmap="Blues", colorbar=False)
plt.title("Confusion matrix at threshold 0.5"); plt.show()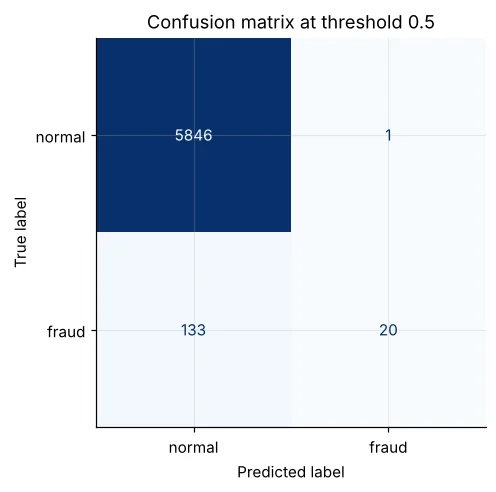
| स्थिति | प्राथमिकता | क्यों |
|---|---|---|
| Fraud, cancer screening | Recall | Case चूकना बहुत महँगा |
| Spam filter, legal notices | Precision | झूठा alarm ज़रूरी email छिपा देता है |
| Loan approval | “Approve” की precision | बुरा loan लाखों का नुकसान |
| Churn campaign | संतुलन (F1) + cost | Calls में पैसा लगता है, खोए customers और महँगे |
ROC curve और AUC
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import roc_auc_score, RocCurveDisplay, PrecisionRecallDisplay, average_precision_score
df = pd.read_csv("upi_transactions.csv")
X, y = df.drop(columns="is_fraud"), df["is_fraud"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
models = {"Logistic": LogisticRegression(max_iter=2000), "Random forest": RandomForestClassifier(n_estimators=200, random_state=0, n_jobs=-1)}
fig, ax = plt.subplots(1, 2, figsize=(11, 4.2))
for name, m in models.items():
    m.fit(X_tr, y_tr); p = m.predict_proba(X_te)[:, 1]
    RocCurveDisplay.from_predictions(y_te, p, name=f"{name} (AUC={roc_auc_score(y_te, p):.3f})", ax=ax[0])
    PrecisionRecallDisplay.from_predictions(y_te, p, name=f"{name} (AP={average_precision_score(y_te, p):.3f})", ax=ax[1])
ax[0].plot([0, 1], [0, 1], "k:", label="random"); ax[0].set_title("ROC curve"); ax[0].legend(fontsize=8)
ax[1].set_title("Precision–recall curve (better for rare events)"); ax[1].legend(fontsize=8)
plt.tight_layout(); plt.show()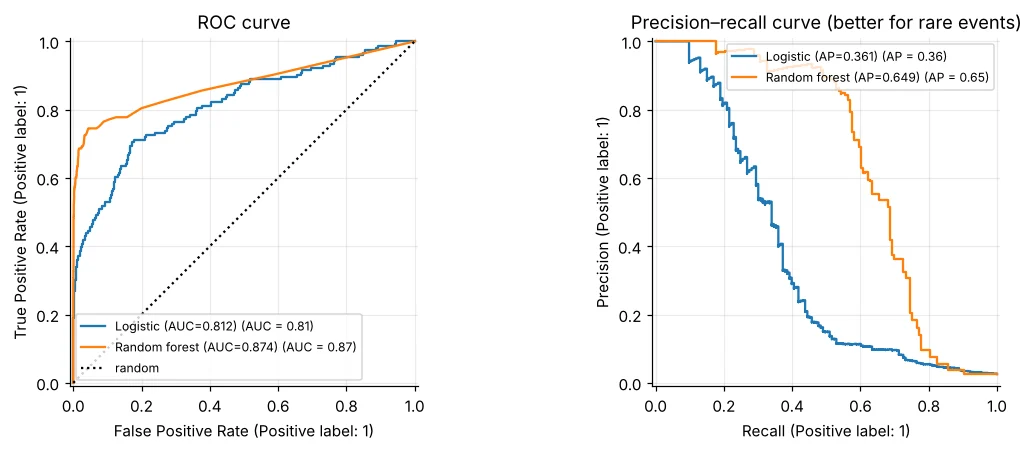
0.5 = random अंदाज़ा, 0.7 = ठीक, 0.8 = अच्छा, 0.9+ = बेहतरीन। AUC threshold पर निर्भर नहीं – यह मापता है कि model cases को कितना अच्छा rank करता है।
Cost से threshold चुनें
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.metrics import precision_score, recall_score
df = pd.read_csv("upi_transactions.csv")
X, y = df.drop(columns="is_fraud"), df["is_fraud"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
p = RandomForestClassifier(n_estimators=200, random_state=0, n_jobs=-1).fit(X_tr, y_tr).predict_proba(X_te)[:, 1]
COST_FN, COST_FP = 8000, 150            # missed fraud ₹8,000; OTP check / annoyed customer ₹150
print("thr  precision recall  missed  alarms   total cost")
best = None
for t in [0.02, 0.05, 0.1, 0.15, 0.2, 0.3, 0.5, 0.7]:
    pred = (p >= t).astype(int)
    fn = int(((pred == 0) & (y_te == 1)).sum()); fp = int(((pred == 1) & (y_te == 0)).sum())
    cost = fn * COST_FN + fp * COST_FP
    best = min(best or (cost, t), (cost, t))
    print(f"{t:.2f}  {precision_score(y_te, pred):.2f}     {recall_score(y_te, pred):.2f}    {fn:4d}   {pred.sum():5d}   ₹{cost:>9,}")
print(f"Cheapest threshold: {best[1]} (₹{best[0]:,})")क्योंकि चूका fraud झूठे alarm से 50× महँगा है, सबसे सस्ता threshold 0.5 से काफ़ी नीचे है – ज़्यादा fraud पकड़ने के लिए ज़्यादा OTP checks मंज़ूर। हमेशा errors को rupees में बदलें।
Class imbalance संभालना
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import recall_score, precision_score
df = pd.read_csv("upi_transactions.csv")
X, y = df.drop(columns="is_fraud"), df["is_fraud"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.3, random_state=0, stratify=y)
for cw in [None, "balanced"]:
    p = LogisticRegression(max_iter=2000, class_weight=cw).fit(X_tr, y_tr).predict(X_te)
print(f"class_weight={str(cw):9s} recall={recall_score(y_te, p):.2f} precision={precision_score(y_te, p):.2f}")- class_weight="balanced" – training में दुर्लभ class की गलतियाँ ज़्यादा महँगी बनाएँ।
- Threshold tuning – अक्सर सबसे आसान और अच्छा उपाय।
- Resampling – majority घटाएँ या minority बढ़ाएँ (imbalanced-learn का SMOTE), सिर्फ़ training data पर।
- PR-AUC / recall / precision लें, सिर्फ़ accuracy कभी नहीं।
🏅 आज के Job Skills
Practice tasks
🏋️ Practice – ख़ुद करें
Solution देखें
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.metrics import classification_report, roc_auc_score
l = pd.read_csv("loan_applications.csv"); l["lti"] = l["loan_amount"] / (l["monthly_income"] * 12)
X, y = l[["credit_score", "lti", "years_employed"]], l["approved"]
a, b, c, d = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)
m = LogisticRegression(max_iter=5000).fit(a, c)
print(classification_report(d, m.predict(b), digits=3)); print("AUC", round(roc_auc_score(d, m.predict_proba(b)[:, 1]), 3))Solution देखें
import numpy as np, pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
l = pd.read_csv("loan_applications.csv"); l["lti"] = l["loan_amount"] / (l["monthly_income"] * 12)
X, y = l[["credit_score", "lti", "years_employed"]], l["approved"]
a, b, c, d = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)
p = LogisticRegression(max_iter=5000).fit(a, c).predict_proba(b)[:, 1]
costs = {t: int(((p >= t) & (d == 0)).sum() * 200000 + ((p < t) & (d == 1)).sum() * 15000) for t in np.arange(0.3, 1.0, 0.025).round(3)}
print(min(costs, key=costs.get), "→ ₹", min(costs.values()))Solution देखें
tp, fp, fn = 40, 60, 10
p, r = tp / (tp + fp), tp / (tp + fn)
print(round(p, 3), round(r, 3), round(2 * p * r / (p + r), 3))
Quick quiz
🧠 Quick Quiz – ख़ुद को जाँचें
Interview corner
💼 Interview Corner
Precision vs recall – हर एक के ज़्यादा ज़रूरी होने का उदाहरण दें।
Fraud या बीमारी screening में recall ज़्यादा ज़रूरी – case चूकना महँगा। Spam filtering या legal action सुझाने में precision ज़्यादा ज़रूरी – झूठे alarms महँगे। हर error की cost से threshold चुनें।
आपके fraud model की accuracy 99% है। क्या यह अच्छा है?
ज़रूरी नहीं। Base rate देखें – fraud 1% हो तो dummy को भी 99% मिलेगा। Recall, precision, PR-AUC और confusion matrix देखें, और baseline से तुलना करें।
सारांश
- Confusion matrix → TP, FP, FN, TN।
- Precision = alerts पर भरोसा, recall = positives की पकड़, F1 संतुलन।
- ROC-AUC models rank करता है; दुर्लभ घटनाओं के लिए PR curves।
- Rupee cost से thresholds; weights या thresholds से imbalance संभालें।
Day 42: KNN और decision trees – दो सहज classifiers और ये boundaries कैसे बनाते हैं।
