दिन 16: Dates, Times और Text Columns
✅ आज आप सीखेंगे
- Dates parse करना और .dt (year, month, day_name)
- Timedelta से समय का अंतर
- Time series पर resample() और rolling()
- .str से text साफ़ करना और खोजना
- Regex से numbers और words निकालना
🏢 असली दुनिया में
दो रोज़ के सवाल: “किस weekday सबसे ज़्यादा orders आते हैं – sale शुक्रवार को चलाएँ या रविवार को?” और “Delhi की हवा November में July के मुकाबले कितनी ख़राब थी?” दोनों के लिए dates चाहिए। तीसरा – “Customers किस बात की शिकायत कर रहे हैं?” – के लिए text।
.dt के साथ dates
import pandas as pd
sales = pd.read_csv("sales_data.csv", parse_dates=["order_date"])
print(sales["order_date"].dtype, sales["order_date"].min().date(), "→", sales["order_date"].max().date())
sales["month"] = sales["order_date"].dt.month
sales["month_name"] = sales["order_date"].dt.strftime("%b")
sales["weekday"] = sales["order_date"].dt.day_name()
sales["is_weekend"] = sales["order_date"].dt.dayofweek >= 5
print(sales[["order_date", "month", "month_name", "weekday", "is_weekend"]].head(3))import pandas as pd
sales = pd.read_csv("sales_data.csv", parse_dates=["order_date"])
order = ["Monday", "Tuesday", "Wednesday", "Thursday", "Friday", "Saturday", "Sunday"]
by_day = sales["order_date"].dt.day_name().value_counts().reindex(order)
print(by_day)
print("Best day:", by_day.idxmax())import pandas as pd
sales = pd.read_csv("sales_data.csv", parse_dates=["order_date"])
sales["festive"] = sales["order_date"].between("2024-10-01", "2024-11-15")
sales["revenue"] = sales["quantity"] * sales["unit_price"] * (1 - sales["discount"])
days = {True: 46, False: 366 - 46}
per_day = sales.groupby("festive")["revenue"].sum() / pd.Series(days)
print(per_day.round())
print("Festive days earn", round(per_day[True] / per_day[False], 1), "x a normal day")Date arithmetic
import pandas as pd
emp = pd.read_csv("employees.csv", parse_dates=["join_date"])
today = pd.Timestamp("2025-01-01")
emp["tenure_days"] = (today - emp["join_date"]).dt.days
emp["tenure_years"] = (emp["tenure_days"] / 365.25).round(1)
emp["review_due"] = emp["join_date"] + pd.DateOffset(years=5)
print(emp[["name", "join_date", "tenure_years", "review_due"]].head(4))
print("Average tenure:", emp["tenure_years"].mean().round(1), "years")resample और rolling: time-series views
import pandas as pd
w = pd.read_csv("delhi_weather.csv", parse_dates=["date"]).set_index("date")
monthly = w["aqi"].resample("ME").mean().round()
print(monthly["2024"].to_string())
print("Worst month:", monthly.idxmax().strftime("%b %Y"), "AQI", int(monthly.max()))import pandas as pd
import matplotlib.pyplot as plt
w = pd.read_csv("delhi_weather.csv", parse_dates=["date"]).set_index("date")
fig, ax = plt.subplots(figsize=(10, 4.2))
ax.plot(w.index, w["aqi"], color="#cbd5e1", lw=0.8, label="Daily AQI")
ax.plot(w.index, w["aqi"].rolling(30).mean(), color="#dc2626", lw=2.2, label="30-day average")
ax.axhline(200, color="#f59e0b", ls="--", lw=1, label="Poor (200)")
ax.set_title("Delhi air quality 2022–2024: every winter is a crisis")
ax.set_ylabel("AQI"); ax.legend()
plt.show()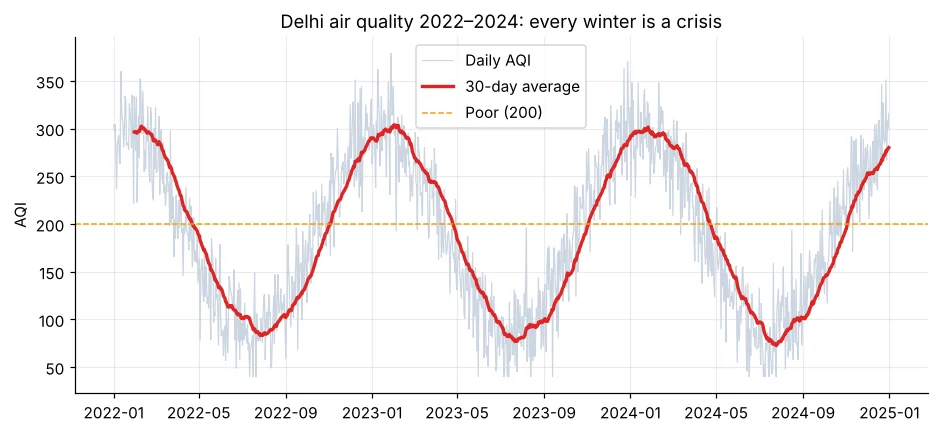
| Code | मतलब |
|---|---|
| "D" / "W" | day / week |
| "ME" / "MS" | month end / month start |
| "QE" | quarter end |
| "YE" | year end |
.str के साथ text
import pandas as pd
rv = pd.read_csv("product_reviews.csv")
print(rv.head(3))
rv["clean"] = rv["review"].str.lower().str.replace(r"[^a-z ]", "", regex=True).str.strip()
rv["words"] = rv["clean"].str.split().str.len()
print(rv[["clean", "words"]].head(3))
print("Average words per review:", rv["words"].mean().round(1))import pandas as pd
rv = pd.read_csv("product_reviews.csv")
text = rv["review"].str.lower()
topics = {"delivery": "deliver|late|courier", "quality": "quality|broke|stopped|faded|cheap",
"size": "size|fit|small|tight", "refund": "refund|return|replace"}
for name, pat in topics.items():
hits = text.str.contains(pat)
print(f"{name:9s} mentioned in {hits.sum():3d} reviews | avg stars {rv.loc[hits, 'stars'].mean():.2f}")import pandas as pd
s = pd.Series(["Order #4521 delivered in 3 days", "Refund of Rs 1,299 for order #4610", "Call 98765-43210 for help"])
print(s.str.extract(r"#(\d+)"))
print(s.str.findall(r"\d+").tolist())
print(s.str.startswith("Order").tolist())Size और refund वाले reviews का औसत 2 stars से कम है – delivery (लगभग 3.1) से कहीं बुरा। इसलिए पहला सुधार बेहतर size chart और तेज़ refund process है, नया courier नहीं। Text analysis 600 reviews को सेकंडों में priority list बना देता है।
🏅 आज के Job Skills
Practice tasks
🏋️ Practice – ख़ुद करें
Solution देखें
import pandas as pd
w = pd.read_csv("delhi_weather.csv", parse_dates=["date"])
print(w.groupby(w["date"].dt.month)["avg_temp_c"].mean().round(1).to_string())Solution देखें
import pandas as pd
s = pd.read_csv("sales_data.csv", parse_dates=["order_date"])
s["day_type"] = s["order_date"].dt.dayofweek.map(lambda d: "Weekend" if d >= 5 else "Weekday")
print(pd.crosstab(s["category"], s["day_type"]))Solution देखें
import pandas as pd
rv = pd.read_csv("product_reviews.csv")
words = rv.loc[rv["sentiment"] == "negative", "review"].str.lower().str.findall(r"[a-z]{4,}").explode()
print(words.value_counts().head(10))Quick quiz
🧠 Quick Quiz – ख़ुद को जाँचें
Interview corner
💼 Interview Corner
Daily sales में seasonality कैसे ढूँढेंगे?
Date column convert करें, index बनाएँ, weekly/monthly totals में resample करें, rolling mean के साथ plot करें, और अलग-अलग सालों का वही महीना मिलाएँ या month/weekday से group करें। आगे decomposition (Day 49) trend और seasonality को अलग करता है।
Python loop की जगह vectorised .str methods क्यों?
ये छोटे हैं, NaN को सुरक्षित संभालते हैं और आमतौर पर तेज़ हैं। Rows पर if-statements वाला loop पढ़ने में मुश्किल और जल्दी टूटने वाला होता है।
सारांश
- parse_dates / to_datetime → .dt.month, .dt.day_name(), .dt.quarter।
- Date में से date = Timedelta; DateOffset months/years जोड़ता है।
- Periods के लिए resample("ME"), moving averages के लिए rolling(n)।
- Text के लिए regex के साथ .str.lower/strip/replace/contains/extract।
Day 17: apply, map, np.where, cut और qcut से नए features बनाएँ – raw columns को business signals में बदलें।
