दिन 43: Random Forest और Gradient Boosting
✅ आज आप सीखेंगे
- भीड़ की समझ: ensembles क्यों जीतते हैं
- Random forest = bagging + random features
- Gradient boosting = गलतियाँ सुधारने वाले trees
- ज़रूरी hyper-parameters और early stopping
- Permutation importance और model चुनना
🏢 असली दुनिया में
असली business tables – loans, churn, prices, demand – पर industry और Kaggle में जीतने वाले models लगभग हमेशा tree ensembles होते हैं: random forests, XGBoost, LightGBM। आज आप सीखेंगे क्यों, और scikit-learn के वे versions कैसे इस्तेमाल करें जिन्हें extra installation नहीं चाहिए।
एक से कई models बेहतर क्यों
import numpy as np
rng = np.random.default_rng(0)
true_price = 60.0
one_expert = rng.normal(true_price, 12, 10000)                      # one noisy guess
crowd = rng.normal(true_price, 12, (10000, 50)).mean(axis=1)        # average of 50 independent guesses
print(f"one model  : typical error ±{np.std(one_expert):.1f} lakh")
print(f"50 averaged: typical error ±{np.std(crowd):.1f} lakh")Bagging (Random Forest)
- Trees अलग-अलग, साथ-साथ बनते हैं
- हर एक bootstrap sample + random features पर
- Votes का औसत → कम variance
- Overfit मुश्किल, कम tuning
Boosting (Gradient Boosting)
- Trees एक के बाद एक बनते हैं
- हर नया tree पिछली गलतियों पर fit
- छोटे कदम (learning rate) → कम bias
- आमतौर पर सबसे accurate, tuning चाहिए
Random forest
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.tree import DecisionTreeRegressor
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error
h = pd.read_csv("house_prices.csv")
X = pd.get_dummies(h.drop(columns="price_lakh"), drop_first=True, dtype=int); y = h["price_lakh"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)
tree = DecisionTreeRegressor(random_state=0).fit(X_tr, y_tr)
rf = RandomForestRegressor(n_estimators=300, oob_score=True, random_state=0, n_jobs=-1).fit(X_tr, y_tr)
print(f"single tree   MAE ₹{mean_absolute_error(y_te, tree.predict(X_te)):.2f} lakh")
print(f"random forest MAE ₹{mean_absolute_error(y_te, rf.predict(X_te)):.2f} lakh | OOB R² {rf.oob_score_:.3f}")हर tree सिर्फ़ ~63% rows देखता है। जो rows उसने नहीं देखीं वे मुफ़्त validation set बनती हैं – OOB score – इसलिए अलग split के बिना performance का अनुमान मिलता है।
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
from sklearn.metrics import mean_absolute_error
h = pd.read_csv("house_prices.csv")
X = pd.get_dummies(h.drop(columns="price_lakh"), drop_first=True, dtype=int); y = h["price_lakh"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)
ns = [1, 3, 10, 30, 100, 300]
maes = [mean_absolute_error(y_te, RandomForestRegressor(n_estimators=n, random_state=0, n_jobs=-1).fit(X_tr, y_tr).predict(X_te)) for n in ns]
plt.figure(figsize=(8, 3.6)); plt.plot(ns, maes, marker="o", color="#16a34a"); plt.xscale("log")
plt.xlabel("number of trees"); plt.ylabel("test MAE (₹ lakh)"); plt.title("More trees → lower error, then it levels off")
plt.show()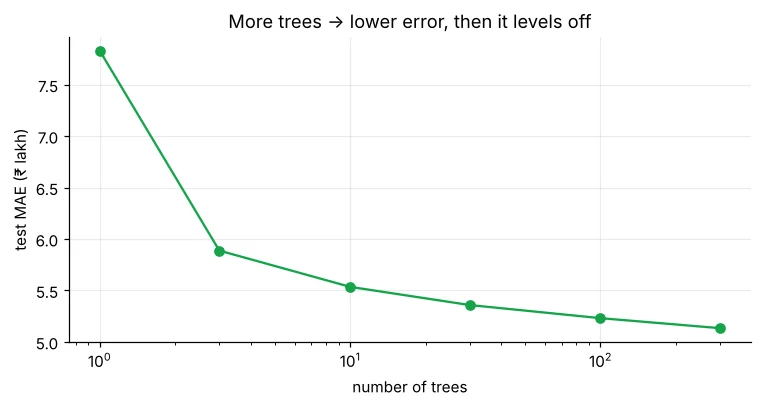
Gradient boosting
import numpy as np
import pandas as pd
from sklearn.tree import DecisionTreeRegressor
h = pd.read_csv("house_prices.csv"); p = h[h["city"] == "Pune"]
X, y = p[["area_sqft", "metro_km", "age_years"]], p["price_lakh"].to_numpy()
pred = np.full(len(y), y.mean())                       # start with the average
lr = 0.3
for step in range(1, 6):
    resid = y - pred                                   # what we still get wrong
    t = DecisionTreeRegressor(max_depth=2, random_state=0).fit(X, resid)
    pred = pred + lr * t.predict(X)                    # take a small step
print(f"step {step}: mean absolute error = {np.abs(y - pred).mean():.2f} lakh")import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor, HistGradientBoostingRegressor
from sklearn.linear_model import LinearRegression
from sklearn.metrics import mean_absolute_error
h = pd.read_csv("house_prices.csv")
X = pd.get_dummies(h.drop(columns="price_lakh"), drop_first=True, dtype=int); y = h["price_lakh"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42)
models = {"Linear regression": LinearRegression(),
"Random forest": RandomForestRegressor(n_estimators=300, random_state=0, n_jobs=-1),
"Hist gradient boosting": HistGradientBoostingRegressor(learning_rate=0.05, max_iter=600, early_stopping=True, random_state=0)}
for name, m in models.items():
m.fit(X_tr, y_tr)
print(f"{name:24s} MAE ₹{mean_absolute_error(y_te, m.predict(X_te)):.2f} lakh")
print("boosting stopped after", models["Hist gradient boosting"].n_iter_, "trees (early stopping)")हमारे data में house prices लगभग गुणात्मक formula (area × city rate × छोटे % असर) से चलती हैं। अच्छे features पर linear model इसे अच्छी तरह पकड़ता है। Ensembles तब चमकते हैं जब रिश्ते उलझे और आपस में जुड़े हों – जैसे नीचे churn और loans। हमेशा तुलना करें!
Classification: loan model
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LogisticRegression
from sklearn.tree import DecisionTreeClassifier
from sklearn.ensemble import RandomForestClassifier, HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score, accuracy_score
l = pd.read_csv("loan_applications.csv")
l["lti"] = l["loan_amount"] / (l["monthly_income"] * 12); l["salaried"] = (l["employment"] == "Salaried").astype(int)
X = l[["monthly_income", "credit_score", "loan_amount", "years_employed", "salaried"]]   # no lti – let models find it
y = l["approved"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)
models = {"Logistic": LogisticRegression(max_iter=5000), "Tree": DecisionTreeClassifier(max_depth=5, random_state=0),
          "Random forest": RandomForestClassifier(n_estimators=400, min_samples_leaf=3, random_state=0, n_jobs=-1),
          "Gradient boosting": HistGradientBoostingClassifier(learning_rate=0.05, max_iter=300, random_state=0)}
for name, m in models.items():
    p = m.fit(X_tr, y_tr).predict_proba(X_te)[:, 1]
print(f"{name:18s} accuracy={accuracy_score(y_te, p > 0.5):.3f} AUC={roc_auc_score(y_te, p):.3f}")हाथ से बने loan_to_income feature के बिना linear model मुश्किल में है, जबकि forests और boosting income × loan interaction ख़ुद ढूँढ लेते हैं। अच्छे features के साथ सरल models बराबर आ जाते हैं – feature engineering अब भी ज़रूरी है।
ज़रूरी hyper-parameters
| Model | Parameter | आम values | असर |
|---|---|---|---|
| Random forest | n_estimators | 200–1000 | ज़्यादा = स्थिर, धीमा |
| Random forest | max_features | "sqrt", 0.3–0.6 | Trees के बीच randomness |
| Random forest | min_samples_leaf | 1–20 | बड़ा = चिकना |
| Boosting | learning_rate | 0.01–0.2 | छोटा = ज़्यादा trees चाहिए, अक्सर बेहतर |
| Boosting | max_iter + early_stopping | 200–2000 | Validation सुधरना रुकने पर रुकता है |
| Boosting | max_depth / max_leaf_nodes | 3–8 / 15–63 | Tree की जटिलता |
Model को कौन से features चलाते हैं?
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestClassifier
from sklearn.inspection import permutation_importance
l = pd.read_csv("loan_applications.csv"); l["salaried"] = (l["employment"] == "Salaried").astype(int)
X = l[["monthly_income", "credit_score", "loan_amount", "years_employed", "salaried"]]; y = l["approved"]
X_tr, X_te, y_tr, y_te = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)
rf = RandomForestClassifier(n_estimators=400, min_samples_leaf=3, random_state=0, n_jobs=-1).fit(X_tr, y_tr)
pi = permutation_importance(rf, X_te, y_te, n_repeats=20, random_state=0, scoring="roc_auc")
imp = pd.Series(pi.importances_mean, index=X.columns).sort_values()
imp.plot(kind="barh", figsize=(7.5, 3.4), color="#4f46e5")
plt.title("Permutation importance: AUC drop when a feature is shuffled"); plt.xlabel("AUC drop"); plt.show()
print(imp.round(3).sort_values(ascending=False).to_string())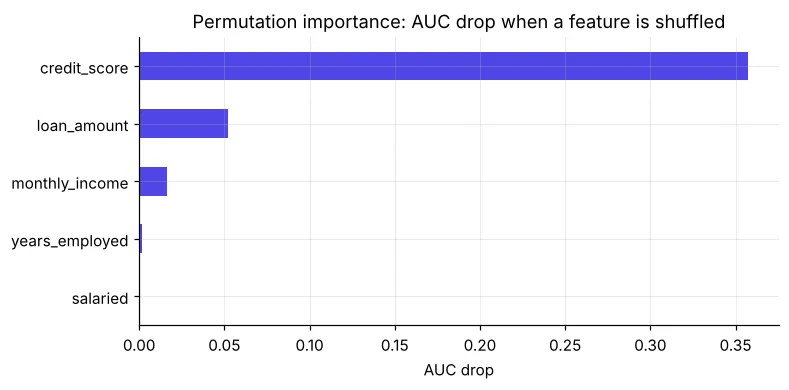
Trees का feature_importances_ बहुत unique values वाले features (जैसे income) को तरजीह देता है। Test set पर permutation importance ज़्यादा भरोसेमंद है।
कौन सा model लूँ?
🏅 आज के Job Skills
Practice tasks
🏋️ Practice – ख़ुद करें
Solution देखें
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import RandomForestRegressor
from sklearn.linear_model import LinearRegression
st = pd.read_csv("students_performance.csv")
X = pd.get_dummies(st.drop(columns=["student_id", "maths", "science", "english", "average", "result"]), drop_first=True, dtype=int)
a, b, c, d = train_test_split(X, st["average"], test_size=0.25, random_state=0)
for m in [LinearRegression(), RandomForestRegressor(n_estimators=300, random_state=0)]:
print(type(m).__name__, round(m.fit(a, c).score(b, d), 3))Solution देखें
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.ensemble import HistGradientBoostingClassifier
from sklearn.metrics import roc_auc_score
l = pd.read_csv("loan_applications.csv")
X, y = l[["monthly_income", "credit_score", "loan_amount", "years_employed"]], l["approved"]
a, b, c, d = train_test_split(X, y, test_size=0.25, random_state=42, stratify=y)
for lr in [0.3, 0.1, 0.03]:
    m = HistGradientBoostingClassifier(learning_rate=lr, max_iter=1000, early_stopping=True, random_state=0).fit(a, c)
print(lr, round(roc_auc_score(d, m.predict_proba(b)[:, 1]), 3), m.n_iter_)lti feature जोड़ें। Logistic regression कितना सुधरता है?Quick quiz
🧠 Quick Quiz – ख़ुद को जाँचें
Interview corner
💼 Interview Corner
Bagging और boosting का फ़र्क समझाइए।
Bagging bootstrap samples पर कई models अलग-अलग train करके औसत लेता है, variance घटाता है (random forest)। Boosting models को क्रम से train करता है, हर एक पिछली गलतियाँ सुधारता है, bias घटाता है (gradient boosting, XGBoost)।
Random forest अकेले tree से कम overfit क्यों करता है?
हर tree अलग bootstrap sample और features का random हिस्सा देखता है, इसलिए उनकी गलतियाँ कम correlated होती हैं; औसत लेने से हर tree का रटा हुआ शोर काफ़ी हद तक कट जाता है।
सारांश
- Ensembles कई trees जोड़ते हैं: bagging variance घटाता, boosting bias घटाता।
- Random forest: मज़बूत default, OOB score, कम tuning।
- Gradient boosting: learning rate + early stopping, सबसे ऊँची accuracy।
- Linear baselines से तुलना करें और permutation importance लें।
Day 44: feature engineering और scaling – encoding, scaling, binning, interactions और leakage से बचाव।
