दिन 38: Linear Regression: House Prices
✅ आज आप सीखेंगे
- विचार: data से होकर एक सीधी line
- Slope और intercept business भाषा में
- Least squares – “best fit” का मतलब
- MAE, RMSE और R² से evaluate
- Residual plots और कब line काफ़ी नहीं
🏢 असली दुनिया में
Pune का एक property portal “price estimate” button चाहता है। Seller flat का size डालता है और तुरंत सही कीमत देखता है। आज आप एक feature – area – से version 1 बनाएँगे और सीखेंगे कि यह कितना ग़लत हो सकता है।
विचार
price = intercept + slope × area। Slope बताता है एक extra square foot कितने lakh जोड़ता है; intercept वह जगह है जहाँ line शून्य area पर मिलती है।
import pandas as pd
from sklearn.linear_model import LinearRegression
h = pd.read_csv("house_prices.csv")
pune = h[h["city"] == "Pune"]
X, y = pune[["area_sqft"]], pune["price_lakh"]
lr = LinearRegression().fit(X, y)
print(f"price ≈ {lr.intercept_:.2f} + {lr.coef_[0]:.4f} × area")
print(f"→ every extra 100 sqft adds about ₹{lr.coef_[0] * 100:.2f} lakh")
for a in [600, 1000, 1500]:
print(f"{a} sqft → ₹{lr.predict(pd.DataFrame({'area_sqft': [a]}))[0]:.1f} lakh")import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
h = pd.read_csv("house_prices.csv"); pune = h[h["city"] == "Pune"]
lr = LinearRegression().fit(pune[["area_sqft"]], pune["price_lakh"])
x = pd.DataFrame({"area_sqft": range(400, 3000, 50)})
fig, ax = plt.subplots(figsize=(9, 4.2))
ax.scatter(pune["area_sqft"], pune["price_lakh"], s=14, alpha=0.5, color="#4f46e5", label="flats in Pune")
ax.plot(x["area_sqft"], lr.predict(x), color="#dc2626", lw=2.5, label="best-fit line")
s = pune.sample(6, random_state=3)
for _, r in s.iterrows():
p = lr.predict(pd.DataFrame({"area_sqft": [r.area_sqft]}))[0]
ax.plot([r.area_sqft, r.area_sqft], [r.price_lakh, p], color="#f59e0b", lw=1.5)
ax.set_xlabel("area (sqft)"); ax.set_ylabel("price (₹ lakh)"); ax.legend()
ax.set_title("Orange lines = errors (residuals). Least squares makes their squares as small as possible")
plt.show()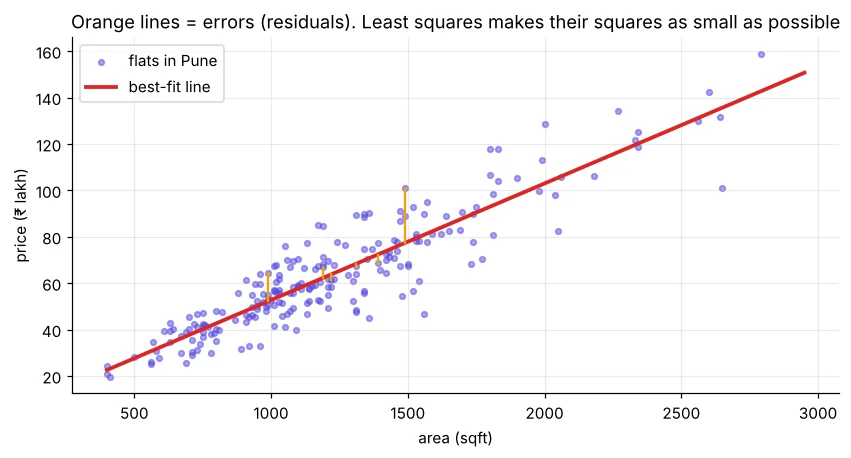
हाथ से least squares
import numpy as np
import pandas as pd
h = pd.read_csv("house_prices.csv"); pune = h[h["city"] == "Pune"]
x, y = pune["area_sqft"].to_numpy(), pune["price_lakh"].to_numpy()
slope = ((x - x.mean()) * (y - y.mean())).sum() / ((x - x.mean()) ** 2).sum()
intercept = y.mean() - slope * x.mean()
print(f"by formula : slope={slope:.5f} intercept={intercept:.3f}")
print(f"np.polyfit : {np.polyfit(x, y, 1).round(5)}")Line कितनी अच्छी है?
import numpy as np
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
from sklearn.dummy import DummyRegressor
from sklearn.metrics import mean_absolute_error, root_mean_squared_error, r2_score
h = pd.read_csv("house_prices.csv"); pune = h[h["city"] == "Pune"]
X_tr, X_te, y_tr, y_te = train_test_split(pune[["area_sqft"]], pune["price_lakh"], test_size=0.25, random_state=7)
for name, m in [("baseline (mean price)", DummyRegressor()), ("linear regression", LinearRegression())]:
    p = m.fit(X_tr, y_tr).predict(X_te)
print(f"{name:22s} MAE={mean_absolute_error(y_te, p):5.2f} RMSE={root_mean_squared_error(y_te, p):5.2f} R²={r2_score(y_te, p):5.3f}")| Metric | मतलब | कब अच्छा |
|---|---|---|
| MAE | औसत absolute error, lakh में | छोटा; समझाना आसान |
| RMSE | MAE जैसा पर बड़ी गलतियों को ज़्यादा सज़ा | छोटा; MAE के क़रीब = कम बड़ी चूकें |
| R² | Price के बदलाव का कितना हिस्सा समझाया (0–1) | 1 के क़रीब; 0 = mean से बेहतर नहीं |
“जो flats model ने नहीं देखे, उन पर estimate औसतन लगभग ₹7.4 lakh ग़लत है, और अकेला area कीमतों के लगभग 86% अंतर समझाता है।”
Residuals: line क्या चूकती है
import pandas as pd
import matplotlib.pyplot as plt
from sklearn.linear_model import LinearRegression
h = pd.read_csv("house_prices.csv"); pune = h[h["city"] == "Pune"].copy()
lr = LinearRegression().fit(pune[["area_sqft"]], pune["price_lakh"])
pune["pred"] = lr.predict(pune[["area_sqft"]]); pune["resid"] = pune["price_lakh"] - pune["pred"]
fig, ax = plt.subplots(1, 2, figsize=(11, 3.8))
ax[0].scatter(pune["pred"], pune["resid"], s=12, alpha=0.6, color="#0891b2"); ax[0].axhline(0, color="#dc2626")
ax[0].set_xlabel("predicted price"); ax[0].set_ylabel("residual"); ax[0].set_title("Residuals vs prediction")
ax[1].scatter(pune["metro_km"], pune["resid"], s=12, alpha=0.6, color="#f59e0b"); ax[1].axhline(0, color="#dc2626")
ax[1].set_xlabel("metro distance (km)"); ax[1].set_title("Residuals fall with metro distance → missing feature!")
plt.tight_layout(); plt.show()
print("corr(residual, metro_km) =", round(pune["resid"].corr(pune["metro_km"]), 2), "| corr(residual, age) =", round(pune["resid"].corr(pune["age_years"]), 2))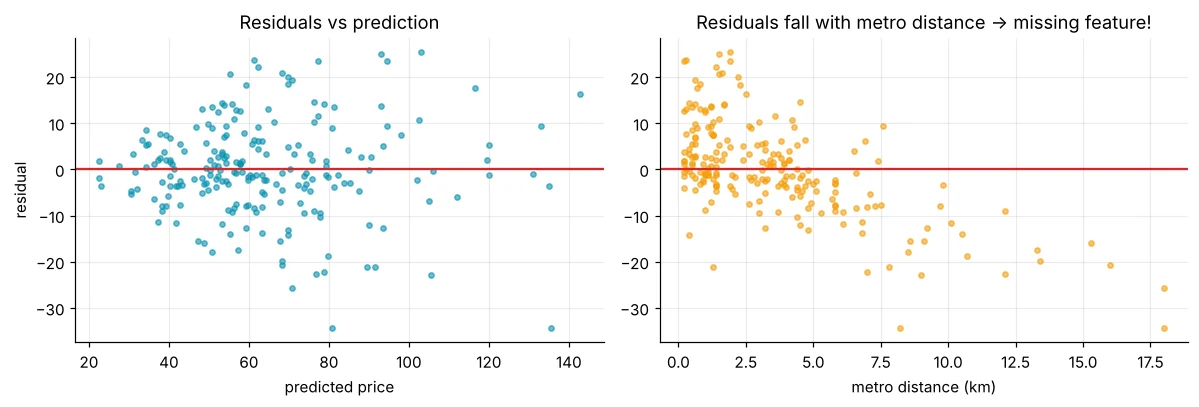
लगभग सीधी-line रिश्ता, स्वतंत्र errors, पूरी range में errors का बराबर फैलाव, और बहुत बड़े outliers का दबदबा नहीं। Residual plots से इन्हें जाँचते हैं।
जब सीधी line काफ़ी नहीं
import pandas as pd
from sklearn.linear_model import LinearRegression
from sklearn.preprocessing import PolynomialFeatures
from sklearn.pipeline import make_pipeline
from sklearn.metrics import r2_score
w = pd.read_csv("delhi_weather.csv", parse_dates=["date"])
w["doy"] = w["date"].dt.dayofyear
X, y = w[["doy"]], w["avg_temp_c"]
line = LinearRegression().fit(X, y)
curve = make_pipeline(PolynomialFeatures(4), LinearRegression()).fit(X, y)
print("straight line R² =", round(r2_score(y, line.predict(X)), 3))
print("degree-4 curve R² =", round(r2_score(y, curve.predict(X)), 3), " ← seasons are not a straight line")🏅 आज के Job Skills
Practice tasks
🏋️ Practice – ख़ुद करें
Solution देखें
import pandas as pd
from sklearn.linear_model import LinearRegression
h = pd.read_csv("house_prices.csv")
for c in ["Lucknow", "Bengaluru"]:
    d = h[h["city"] == c]; m = LinearRegression().fit(d[["area_sqft"]], d["price_lakh"])
print(c, "₹", round(m.coef_[0] * 100, 2), "lakh per extra 100 sqft")Solution देखें
import pandas as pd
from sklearn.model_selection import train_test_split
from sklearn.linear_model import LinearRegression
st = pd.read_csv("students_performance.csv")
a, b, c, d = train_test_split(st[["study_hours"]], st["average"], test_size=0.25, random_state=0)
print(round(LinearRegression().fit(a, c).score(b, d), 3))Solution देखें
import pandas as pd
from sklearn.linear_model import LinearRegression
t = pd.read_csv("telecom_churn.csv").dropna()
m = LinearRegression().fit(t[["tenure_months"]], t["total_charges"])
print("Each extra month ≈ ₹", round(m.coef_[0]), "more total charges")Quick quiz
🧠 Quick Quiz – ख़ुद को जाँचें
Interview corner
💼 Interview Corner
Non-technical व्यक्ति को R² समझाइए।
“हमारा model लगभग 80% समझाता है कि flats की कीमतें अलग क्यों हैं; बाकी 20% उन चीज़ों से है जो model नहीं जानता।” इसे ठोस बनाने के लिए rupees में MAE जोड़ें।
MAE या RMSE – कौन सा report करेंगे?
Stakeholders के लिए MAE क्योंकि यह साधारण units में और पढ़ने में आसान है। जब बड़ी गलतियाँ ख़ास महँगी हों तब RMSE। अक्सर दोनों बताएँ।
सारांश
- Linear regression least squares से y = intercept + slope × x fit करता है।
- Slope = x की एक unit पर y का बदलाव।
- Test data पर evaluate: mean baseline के सामने MAE, RMSE, R²।
- Residual patterns छूटे features दिखाते हैं।
Day 39: सभी features के साथ multiple regression, और model को ईमानदार रखने के लिए Ridge व Lasso।
